- Automatización con IA
- Gobierno de Datos
Por qué el modelo de IA correcto para un negocio regulado suele ser uno pequeño
El modelo de frontera es el de los titulares. El que sobrevive una revisión de cumplimiento normalmente es más chico, más barato, afinado con material propio y corriendo en un lugar que se puede señalar en un mapa.
Toda conversación sobre IA empieza en el mismo lugar: cuál modelo es el mejor.
Es la primera pregunta equivocada para casi cualquier empresa, y especialmente para las que atendemos, las aseguradoras, la manufactura, las instituciones educativas y la práctica clínica, donde la restricción real nunca es la capacidad bruta.
La restricción real es que alguien, en algún momento, va a preguntar a dónde se fueron los datos. Y la respuesta "a una API de un tercero en otro país, y no tenemos certeza de qué retuvieron" es mala en un consejo, peor en una auditoría e irrecuperable en una controversia.
Lo interesante de 2026 es que ya no hay que elegir entre un modelo lo bastante bueno para ser útil y un despliegue defendible. Para una clase amplia de tareas reales se pueden tener ambos, y el modelo que lo permite normalmente es uno chico.
Qué es un modelo de lenguaje pequeño, en términos llanos
Un modelo de lenguaje pequeño (SLM, por sus siglas en inglés) tiene entre unos pocos millones y alrededor de 7 mil millones de parámetros: lo bastante chico para correr en hardware ordinario, un solo servidor o a veces una laptop, en lugar de un clúster rentado.
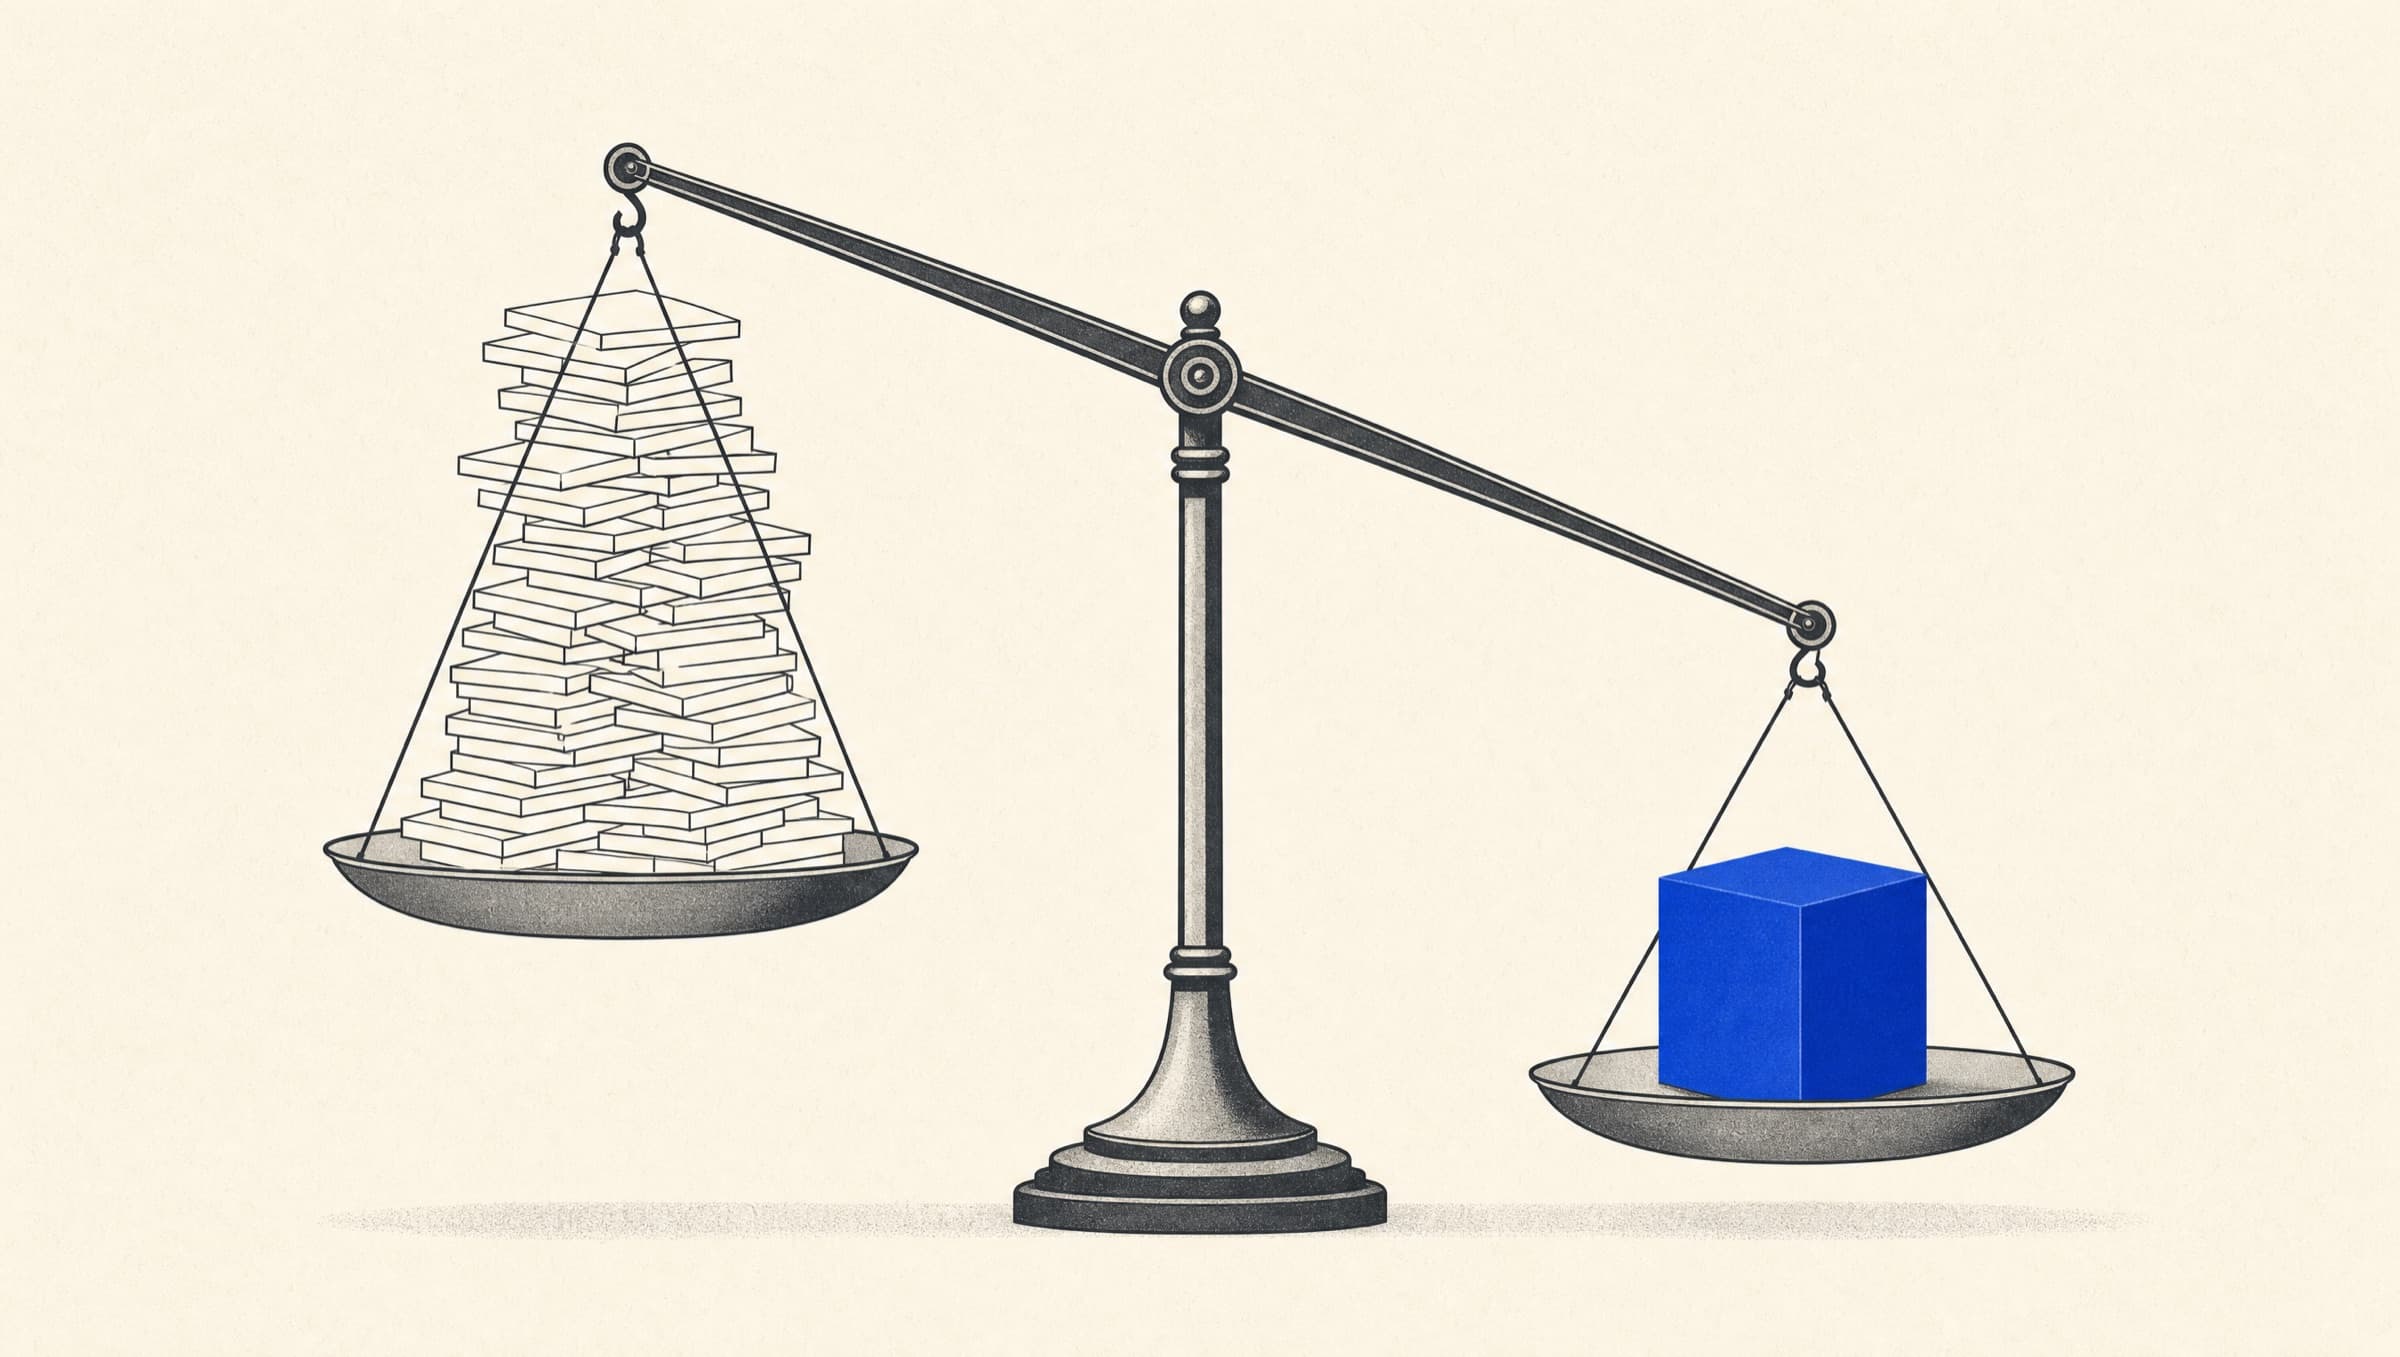
El intercambio es directo. Un modelo de frontera sabe muchísimo sobre todo. Un modelo pequeño sabe bastante menos sobre todo, y se le puede enseñar a ser muy bueno en una cosa: los tipos de documento de una empresa, su terminología, sus categorías, su definición de respuesta correcta.
Para razonamiento de propósito general gana el modelo de frontera, y no está cerca. Para "leer esta forma específica y extraer estos once campos, como lo haría nuestro ajustador senior", la brecha se cierra mucho, y después de afinarlo con ejemplos reales, con frecuencia se cierra o se invierte.
Ya no es una postura marginal. El panorama 2026 de TechCrunch citó a Andy Markus, de AT&T, prediciendo que los SLM afinados se volverían un básico de las empresas maduras en IA este año, por costo y desempeño.
Las tres razones por las que gana en un entorno regulado
1. Se puede decir dónde están los datos
Esta es la que decide la compra, y no es principalmente técnica.
Cuando un modelo corre sobre infraestructura propia, la respuesta a "a dónde van nuestros datos" es un lugar. Se puede nombrar la máquina, la jurisdicción y la política de retención, y se puede poner en un contrato sin la lista de subprocesadores de un proveedor a media respuesta.
Eso importa más en México que hace dos años. La reforma de marzo de 2025 disolvió al INAI y trasladó la vigilancia en materia de datos personales a un nuevo órgano, Transparencia para el Pueblo, dentro de la Secretaría Anticorrupción y Buen Gobierno. Las obligaciones no desaparecieron; cambió la institución que las supervisa. En un periodo donde la postura de aplicación está genuinamente en transición, poder demostrar exactamente dónde se procesan los datos personales vale más que una lectura favorable de una cláusula.
Para nuestros clientes esto aparece más en lo comercial que en lo legal. El área de auditoría de una aseguradora hace la pregunta. El comité de una universidad la hace. El proyecto avanza o no según la calidad de la respuesta.
2. La economía se invierte con el volumen
Una API de frontera es barata por llamada y cara por año a escala. Un modelo pequeño autohospedado es al revés: costo de arranque real, y después un costo marginal cercano a la electricidad.
El punto de cruce llega antes de lo que casi cualquier equipo espera, porque las cargas que vale la pena automatizar son justamente las repetitivas y de alto volumen: los mismos documentos, miles de veces al mes. Ese es el perfil donde el precio por llamada se acumula y un despliegue de costo fijo deja de parecer conservador y empieza a parecer obvio.
También hay un argumento de latencia, más significativo en la operación que el de costo. Un modelo local responde en milisegundos sin un viaje redondo a otro país, y sigue respondiendo cuando el servicio de alguien más tiene un incidente.
3. La operación no queda expuesta a la hoja de ruta de otro
El riesgo que se volvió concreto en el último año es la dependencia. Los modelos se descontinúan, los precios cambian, los términos cambian, y una capacidad de la que una operación ya depende puede ser reajustada por una empresa con la que no hay más relación que una tarjeta de crédito.
Esa es la tesis detrás de muchísima inversión reciente. Prime Intellect levantó 130 millones de dólares en julio de 2026 específicamente para ayudar a empresas a entrenar y poseer sus propios modelos, con una valuación de mil millones y clientes como Ramp y Zapier. El cofundador de Ramp reportó que su propio agente superó a los modelos de frontera en exactitud, corriendo más rápido y mucho más barato. David Katz, de Radical Ventures, planteó la ansiedad de fondo sin rodeos: ¿cómo saber que el proveedor de IA no va a terminar compitiendo con quien lo contrata?
Para una startup esa es una pregunta estratégica. Para una aseguradora mediana es más simple: ¿lo que sostiene nuestra operación de siniestros es algo que controlamos?
Dónde un modelo pequeño es la respuesta equivocada
Preferimos decirlo antes de que un cliente lo descubra.
Razonamiento abierto. Si la tarea es "leer este contrato y señalar qué tiene de inusual", conviene el modelo más grande disponible. La amplitud es todo el trabajo, y un modelo especializado va a pasar por alto, con toda seguridad, justo lo que hacía falta.
Volumen bajo. Montar inferencia hospedada para procesar cuarenta documentos al mes es un pasatiempo con calendario de mantenimiento. Ahí basta una API.
Sin datos de entrenamiento. Afinar requiere ejemplos reales con respuestas correctas conocidas. Si nadie ha registrado nunca cuál era la respuesta correcta, primero hay un proyecto de recolección de datos, y fingir lo contrario cuesta un trimestre.
Sin quién lo opere. Un modelo autohospedado es infraestructura. Necesita parches, monitoreo y alguien responsable cuando se detiene. Si esa capacidad no existe ni se está contratando, la recomendación honesta es un servicio administrado.
La arquitectura realista para la mayoría no es una u otra. Es un modelo pequeño atendiendo el trabajo sensible, bien definido y de alto volumen dentro de la frontera propia, y un modelo de frontera invocado para los casos raros, difíciles y abiertos, con una regla explícita sobre qué datos pueden salir.
Cómo decidir, en cuatro preguntas
- ¿Cuántas veces al mes corre esta tarea? Menos de unos cientos, conviene una API. En los miles, vale la pena modelar en serio la opción de costo fijo.
- ¿Incomodaría leer estos datos en voz alta en una diligencia? Si no, no deberían salir de infraestructura propia.
- ¿Hay cien ejemplos de la respuesta correcta? Si sí, afinar es viable. Si no, ese es el primer proyecto.
- ¿Quién le aplica parches a las 2 de la mañana? Si no hay un nombre, lo sensato es contratar administrado y revisarlo en un año.
En resumen
La industria pasó tres años argumentando que más grande es mejor, y para inteligencia general el argumento era correcto.
La mayoría de los problemas de negocio no son problemas de inteligencia general. Son estrechos, repetitivos, de alto volumen y envueltos en restricciones sobre dónde puede estar la información. En esa forma específica de problema, un modelo más chico corriendo dentro de la frontera propia suele ser más exacto, considerablemente más barato, más rápido y mucho más fácil de defender.
La pregunta que vale la pena no es cuál modelo es el mejor. Es cuál modelo va a seguir operando, sin cambios y con explicación, dentro de tres años.
Construimos ambos patrones según lo que el problema amerite: nuestra práctica de automatización con IA describe cómo decidimos, y dónde sí paga la automatización cubre la pregunta previa de si conviene automatizar la tarea.